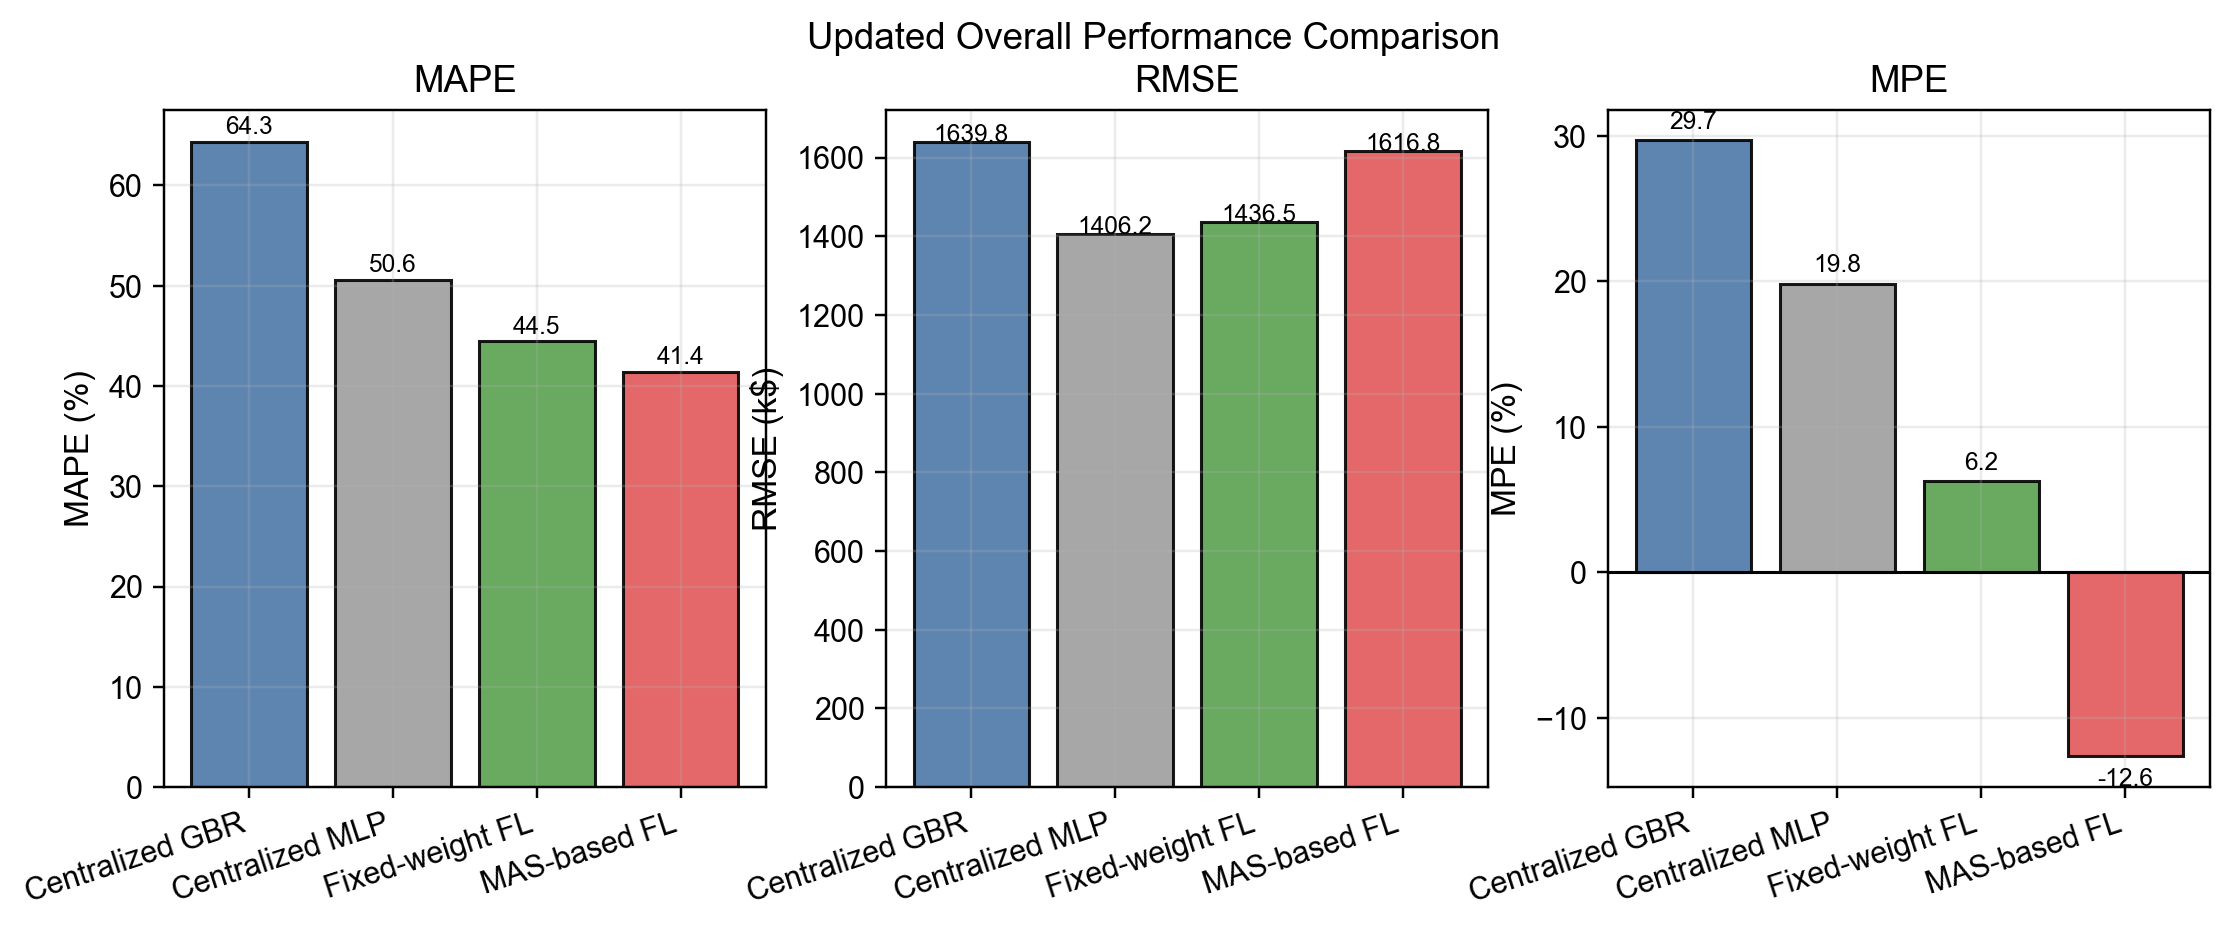
早期实验演示:本页图表和数值属于历史版本。当前简历结果为相较 FedAvg,MAPE 降低 6.81%。 返回项目详情
← → 翻页 · B 静态 · ESC 索引
MAS-FL-LLM2024

Federated Learning × Multi-Agent × LLM

智能体增强

联邦学习

面向公路工程造价估算的隐私保护框架

Agent-Augmented Federated LearningHighway Cost Estimating
MAS-FL-LLM Framework01 / 20
Background

Research Context

公路造价估算

造价估算直接影响项目立项、资金配置与施工控制,偏差往往导致资源浪费或项目失败。

工程造价数据涉及企业成本结构、报价策略及资源配置等商业机密,各方无法直接共享数据。

随着数据安全与隐私保护法规加强,多方数据汇集面临高合规约束,形成"数据孤岛"问题。

基于单一数据源训练的模型过度依赖特定分布,泛化能力不足。

现有方法缺乏对多主体协同建模的系统性框架,模型构建仍依赖大量人工经验与反复调参。

Webster et al. 2024 · Karadimos 2024

如何在不共享原始数据的前提下实现多方协同建模,成为工程造价估算的关键问题。

Core Research Question
研究背景02 / 20
Dataset

Data Heterogeneity

数据异构性
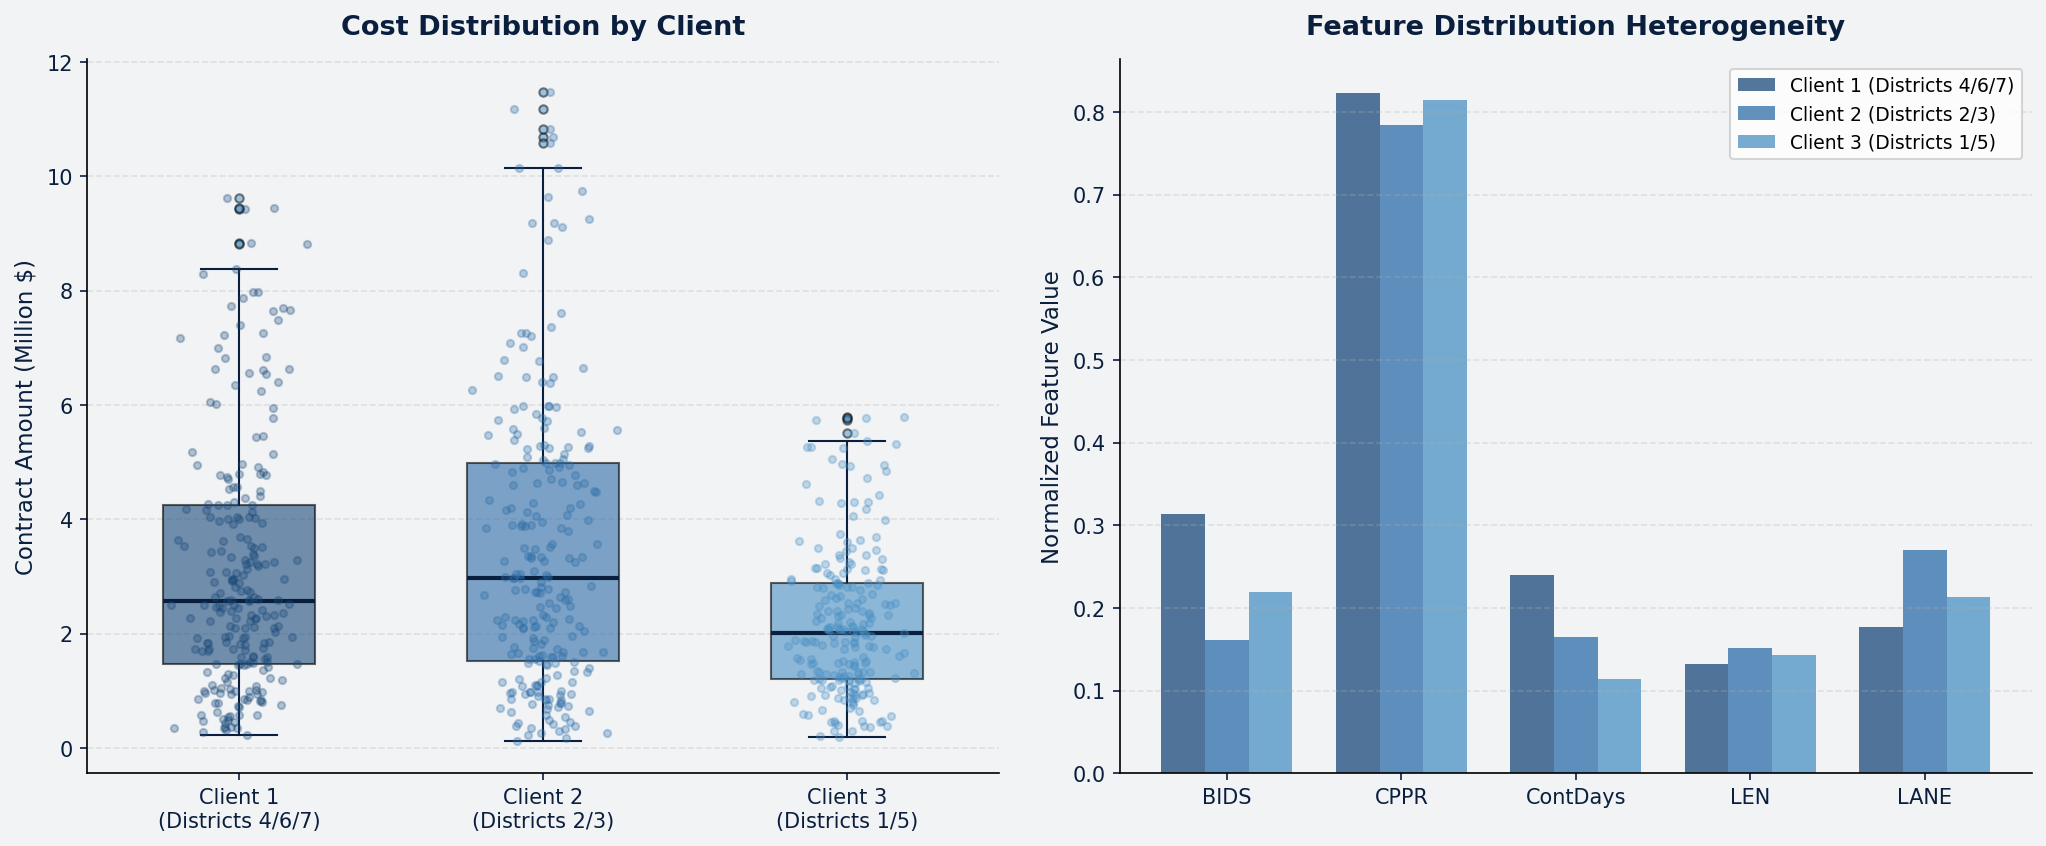
Data Heterogeneity
Fig. Cost distribution & feature heterogeneity across 3 clients
Total Samples688Florida DOT 公路项目 (2002-2012)
Features10BIDS, CPPR, ContDays, LEN, LANE, WDays, CPI, ContSpend, PLR, PPI
Clients3按地理邻近性分组 · 7 个行政区 → 3 个客户端
Client 1: 233 · Client 2: 235 · Client 3: 220
数据概览03 / 20
Methodology

Chapter 01

方法论

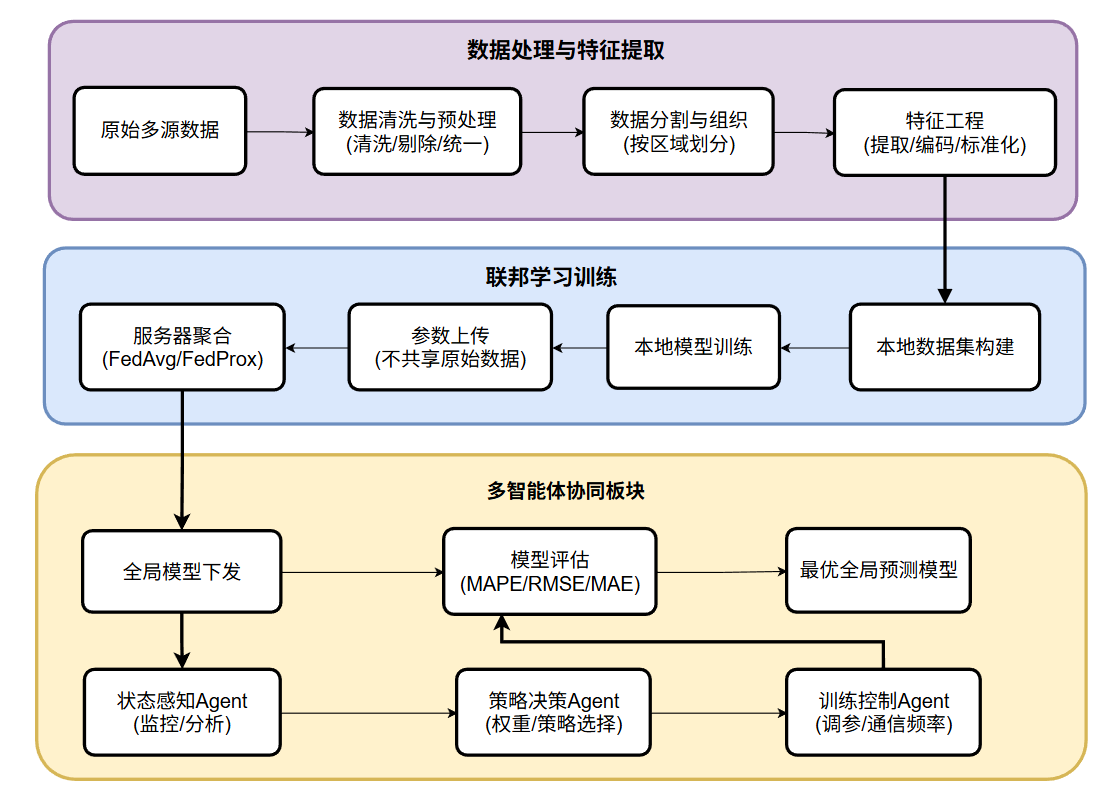
MAS-FL-LLM:三阶段框架

Stage 1 · FL TrainingStage 2 · MASStage 3 · LLM Decision
方法论04 / 20
Framework

Overall Architecture

整体框架设计

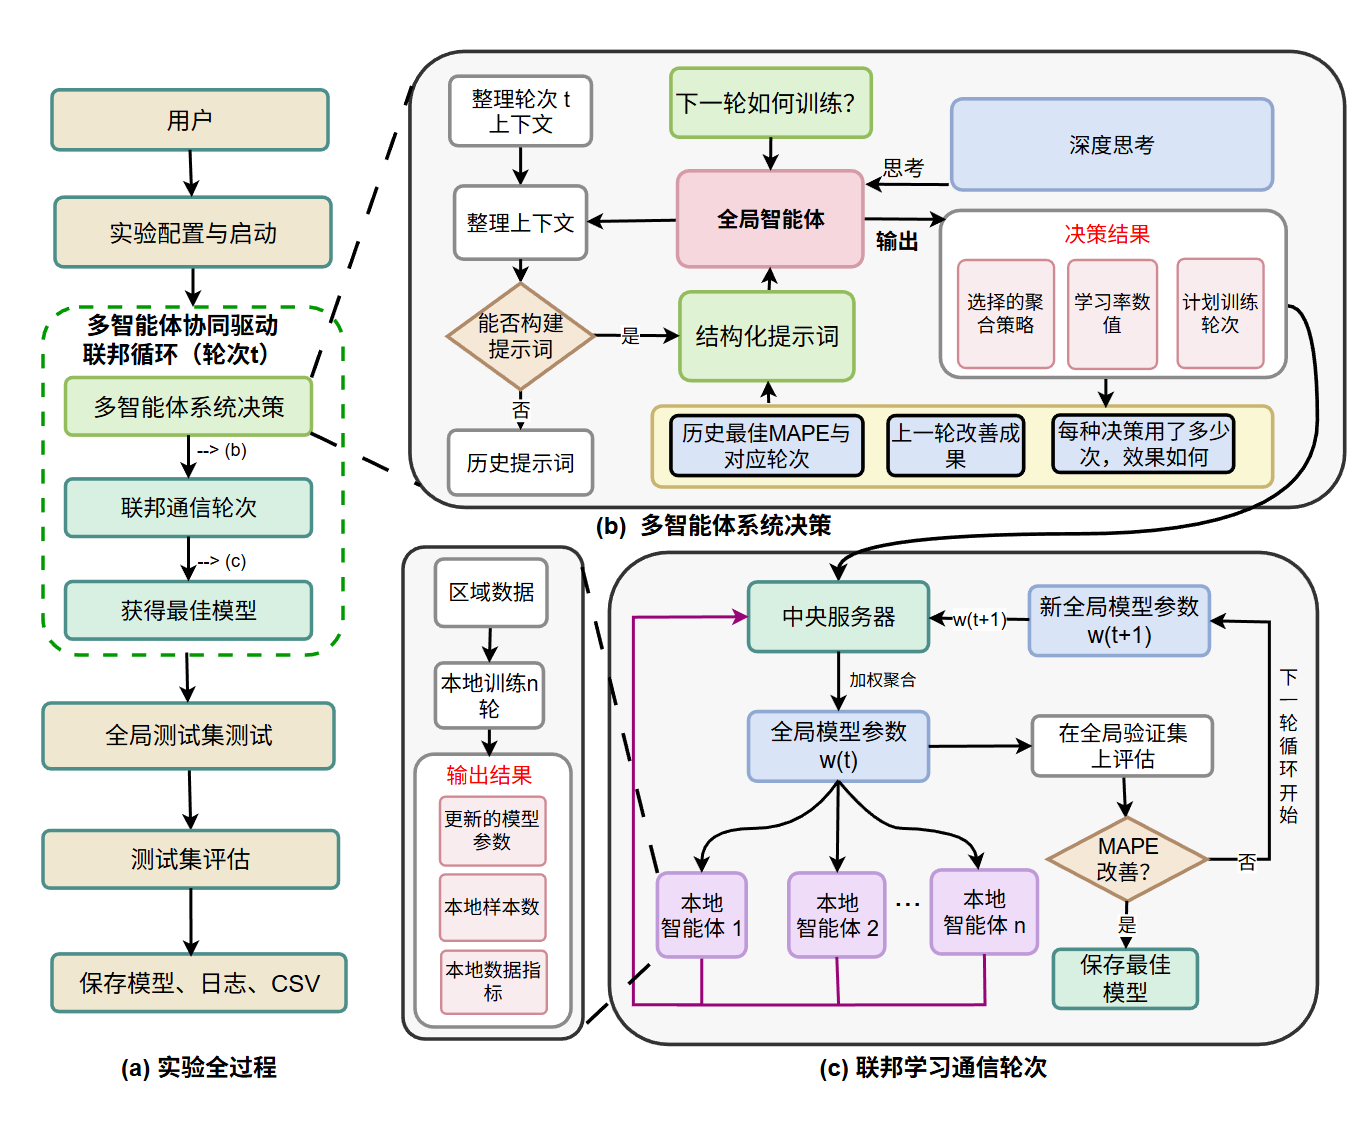
Methodology Framework
Fig. MAS-FL-LLM overall methodology framework
整体框架05 / 20
Stage 1

Federated Learning

联邦训练架构

FL Training Architecture
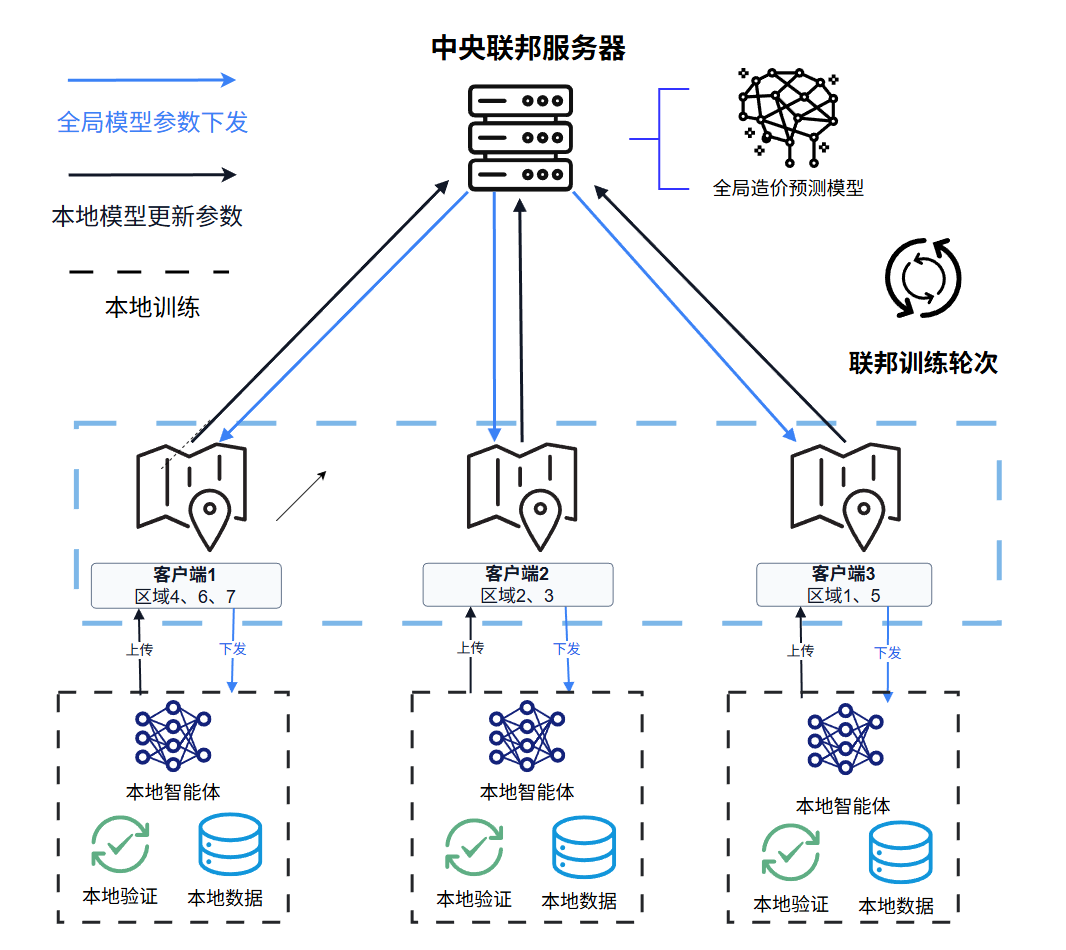
Fig. Horizontal FL with MLP predictor

水平联邦学习 + MLP 预测器

每个客户端本地训练 MLP 模型,通过 FedAvg 聚合参数。

MLP 结构:输入层(10) → 隐藏层(128→128→64→32) → 输出层(1),共 28,993 参数

激活函数:GELU,优化器:Adam (lr=0.0005, weight_decay=1e-4),Dropout=0.1

目标变量:ContAmnt^0.25 幂变换,逆变换 Y^4 还原
联邦训练06 / 20
Stage 2
MAS-FL Architecture

Multi-Agent System

多智能体系统

Local Agents + Central Agent 协作

Local Agent:数据预处理(联邦标准化)、本地训练(FedProx, mu=0.01)、性能报告生成。

Central Agent (DeepSeek LLM):接收各客户端报告,从 4 种策略中动态选择聚合方式。

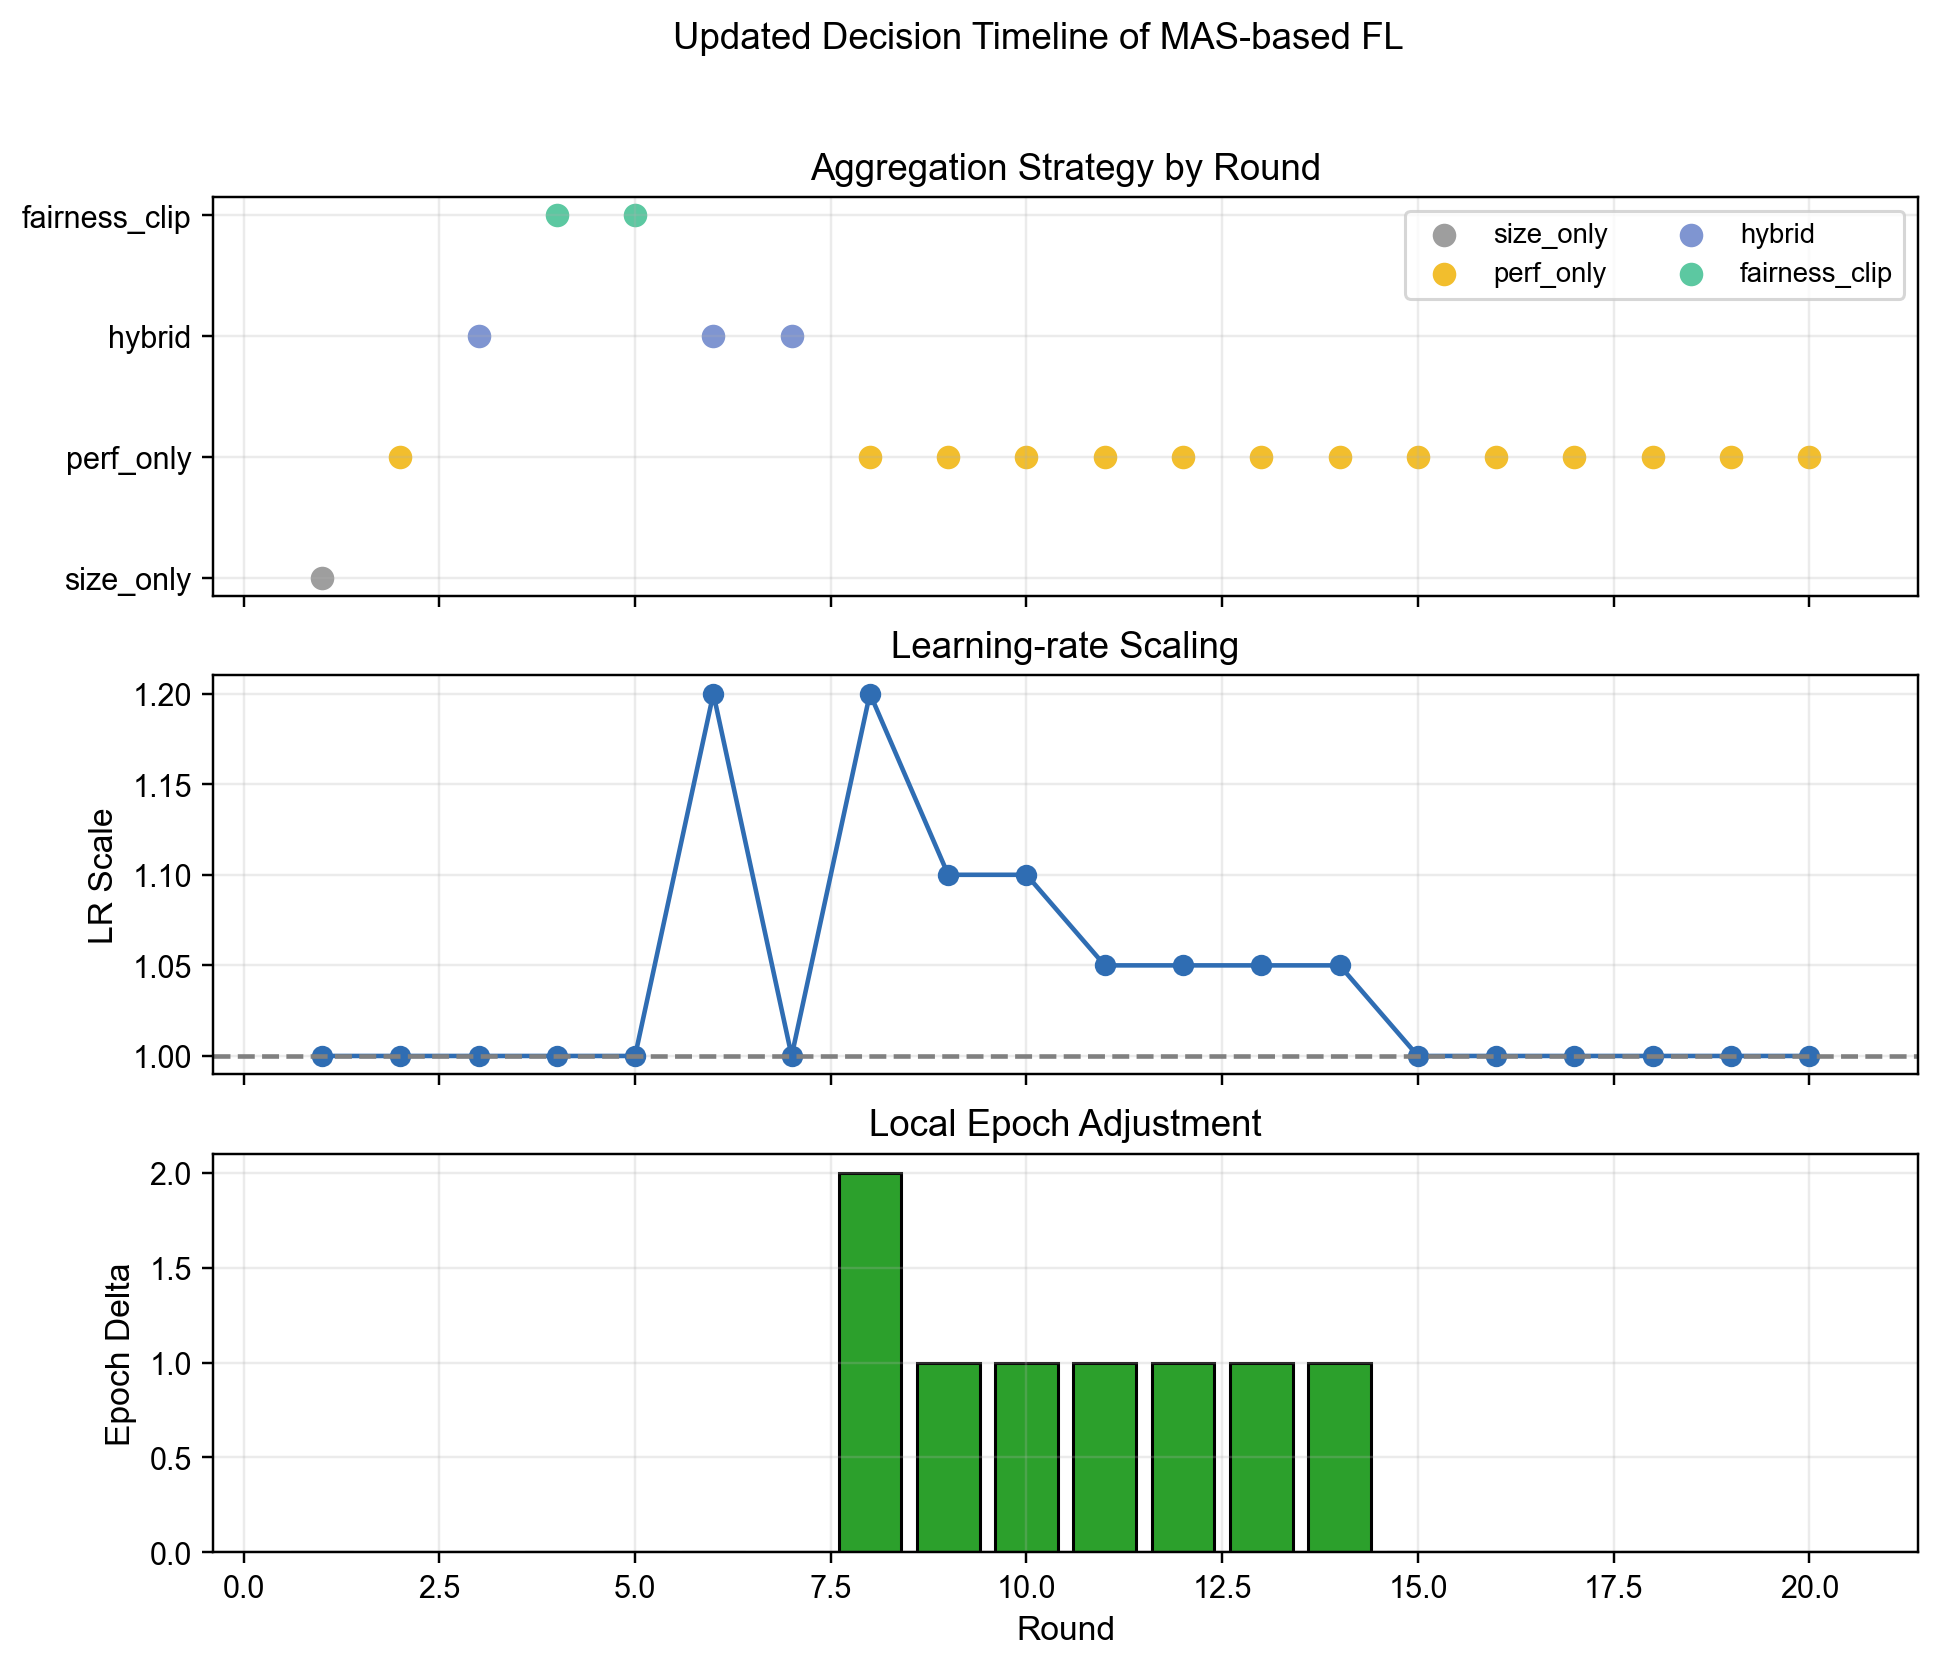
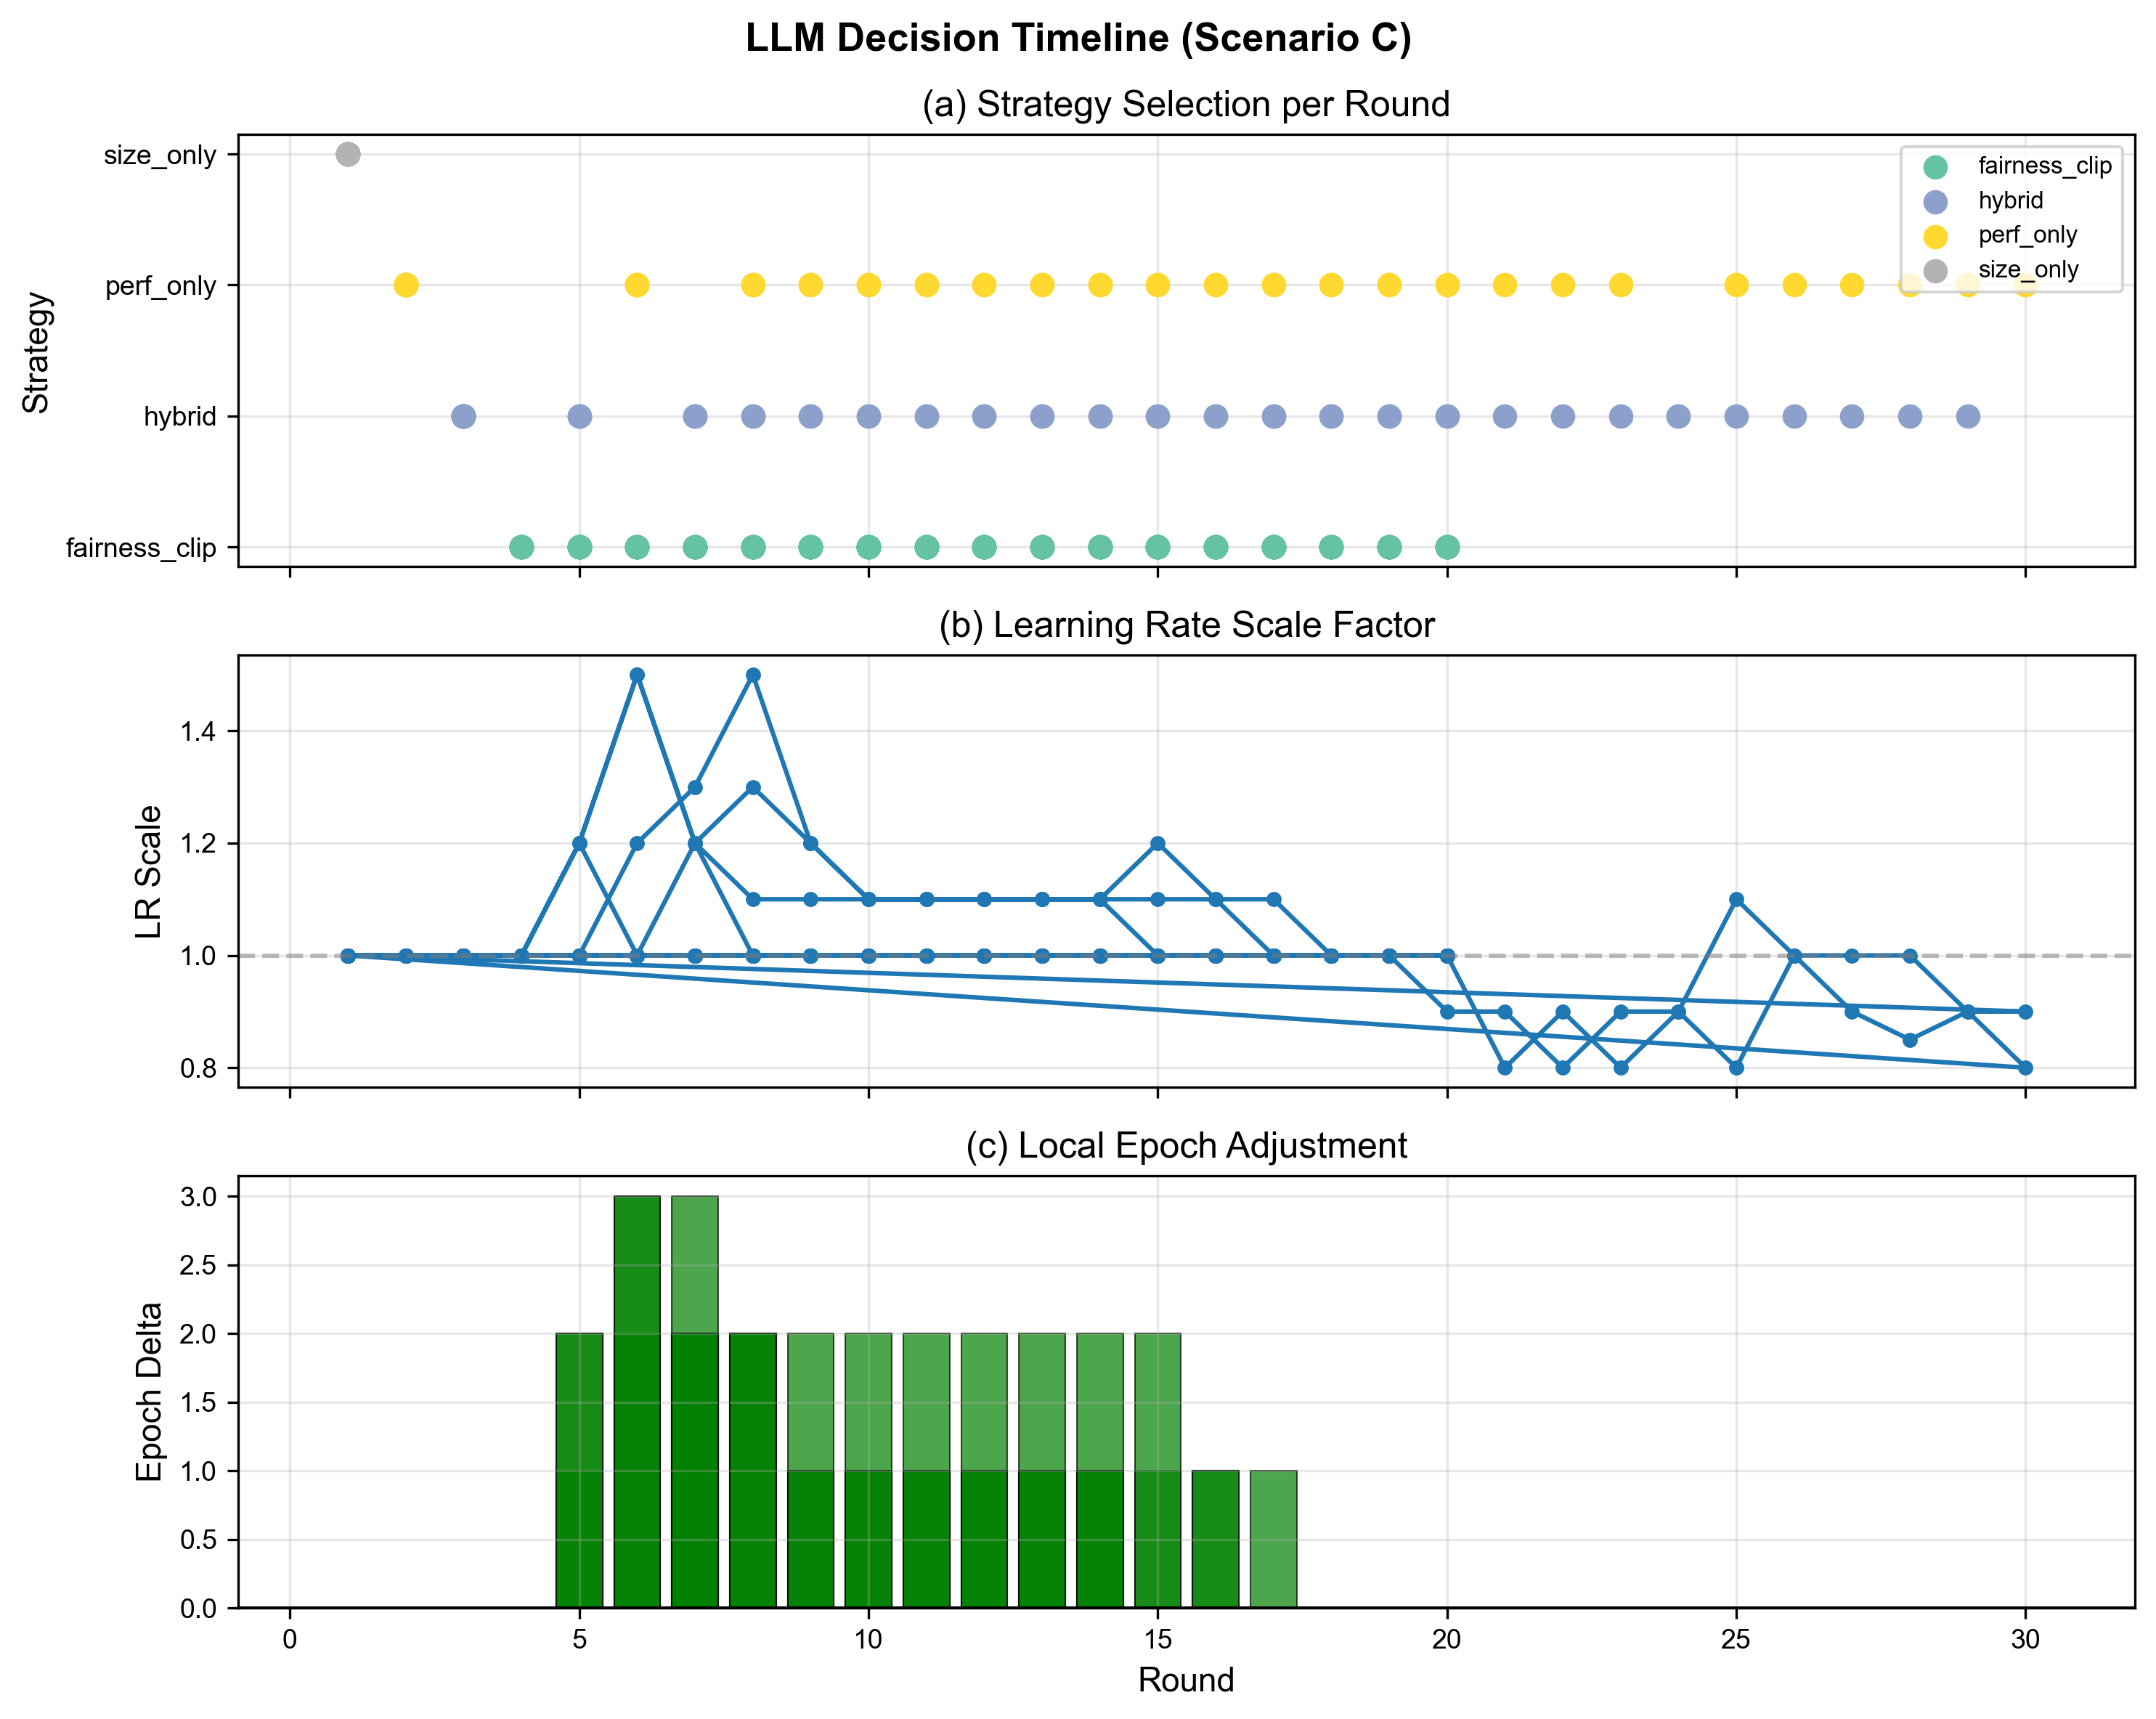
4 种策略:size_only / perf_only / hybrid / fairness_clip,前 4 轮强制探索,第 5 轮起 LLM 决策。

多智能体07 / 20
Stage 3

LLM-Driven Aggregation

LLM 动态决策算法

Algorithm 1: MAS-FL-LLM
Input: K clients, T rounds, η, E
1: Initialize global model θ₀
2: for t = 1 to T do
3:   for each client k in parallel
4:     θₖ ← LocalTrain(θ, Dₖ, E, η)
5:     sₖ ← Evaluate(θₖ, Vₖ)
6:   Collect S = [s₁, s₂, ..., sₖ]
7:   w ← LLM(S)  // DeepSeek 决策
8:   θ ← Σ wₖ · θₖ
9: return θ_T

核心创新:第 7 行

传统 FedAvg 使用固定权重 wₖ = nₖ/N(数据量比例),LLM 则根据实时状态矩阵 S 动态输出权重。

状态向量 sₖ 包含:MAPE、Loss、数据量、训练轮次等多维指标。

约束条件:Σwₖ = 1, wₖ ≥ 0

前 4 轮强制探索 4 种策略,第 5 轮起 LLM 自主决策。

LLM 决策引擎08 / 20
Decision

Decision Process

LLM 决策流程

Decision Process
Fig. LLM decision-making process for weight allocation
决策流程09 / 20
Workflow

Three-Stage Pipeline

三阶段工作流

MAS-FL-LLM Pipeline
01本地训练各客户端独立训练 MLP,生成性能报告(Loss、MAPE、数据分布)
02智能体通信Local Agent 将报告发送至 Central Agent,LLM 分析各客户端状态
03动态聚合LLM 输出聚合权重,服务器加权平均模型参数,广播全局模型

每轮通信中,LLM 根据实时训练状态调整权重,而非使用固定比例。

工作流10 / 20
Results
42%

Chapter 02

实验结果

MAPE 42.07% · 20 轮收敛 · 偏差修正 MPE -15.8% → -1.3%

实验结果11 / 20
Performance

Overall Comparison

整体性能对比

Overall Results
Fig. Four-scenario performance comparison (MAPE / RMSE / MAE / R²)
MAS-FL-LLM MAPE42.07%本研究方法
FedAvg MAPE55.15%标准联邦学习
Centralized GBR64.33%集中式基线
性能对比12 / 20
Convergence

Training Dynamics

收敛分析

Convergence
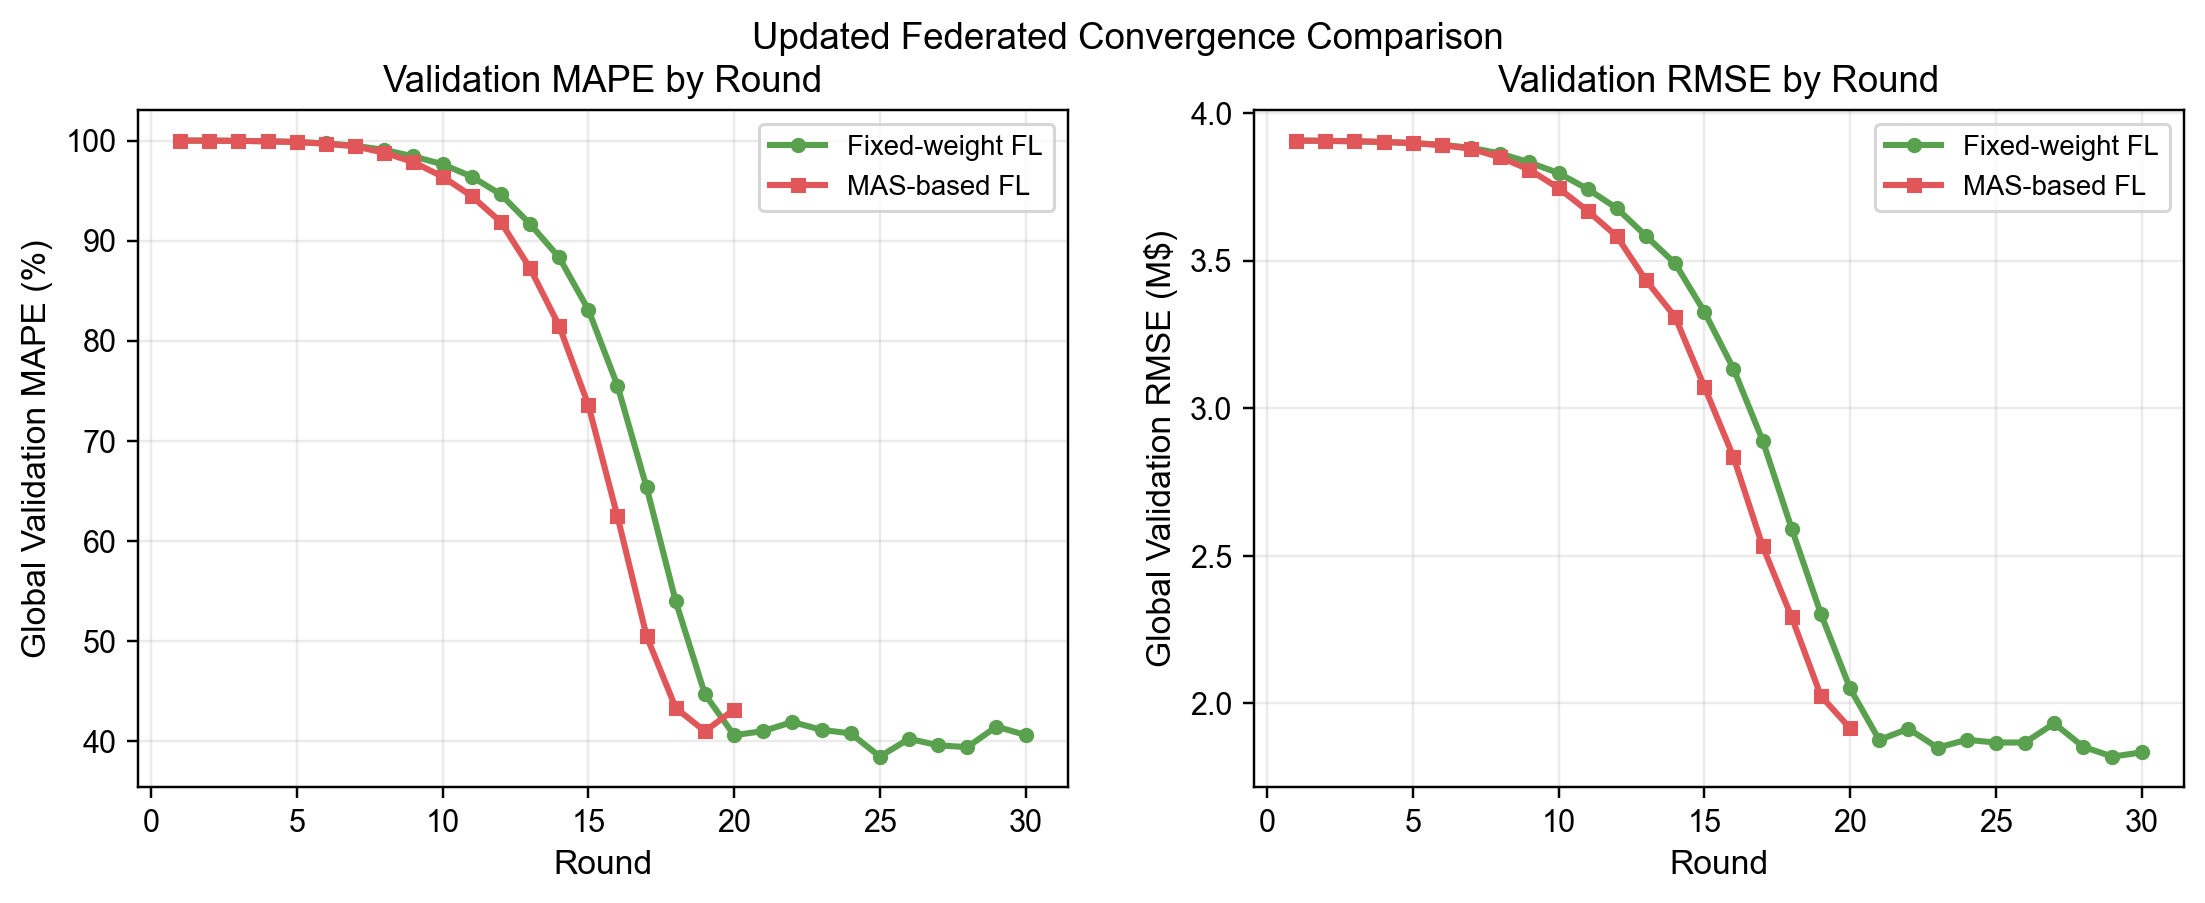
Fig. Convergence curves comparison

更快收敛,更少通信

MAS-FL-LLM 在第 20 轮达到最优,而 FedAvg 需要 30 轮。

LLM 动态权重使模型在早期快速聚焦于高质量客户端,后期平衡各方贡献。

通信效率提升 33%,在带宽受限场景下优势显著。

收敛分析13 / 20
Validation

Client-Level Results

客户端验证

Client Validation
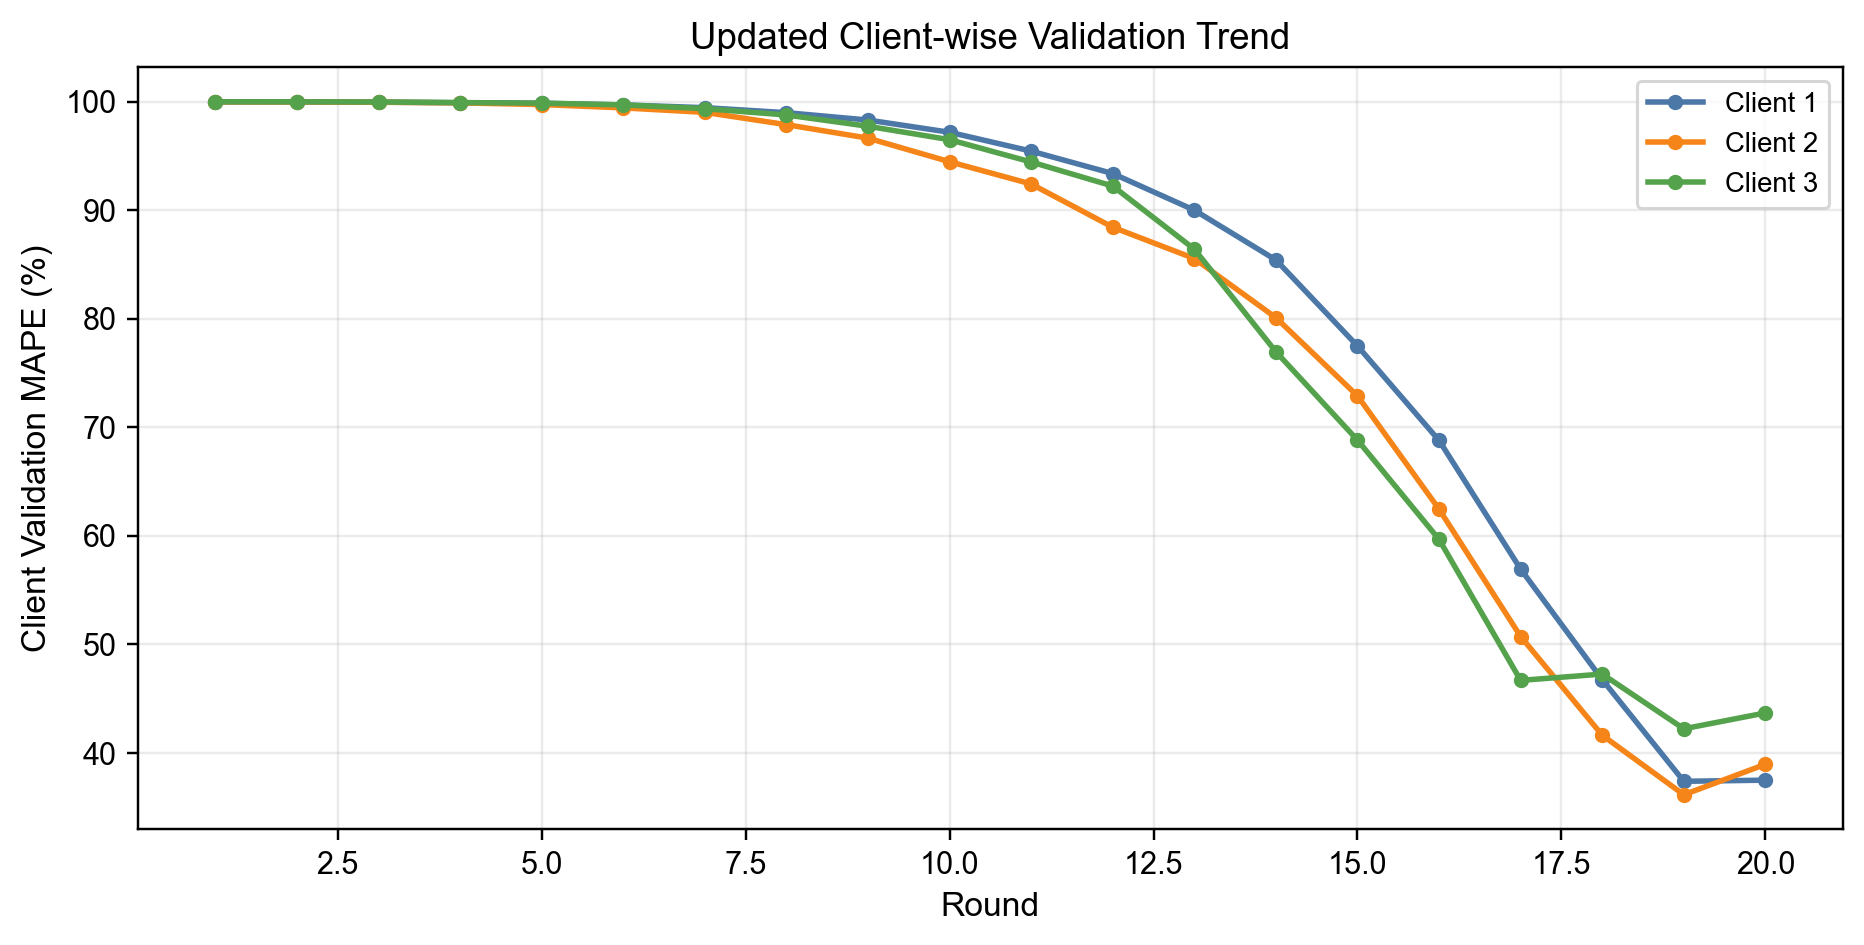
Fig. Per-client validation performance

各客户端均获提升

Client 1(Districts 4/6/7,233 样本):最终 MAPE 40.44%

Client 2(Districts 2/3,235 样本):最终 MAPE 36.94%

Client 3(Districts 1/5,220 样本):最终 MAPE 36.05%

三个客户端按地理邻近性分组,各自保留独立的区域数据分布特征。

客户端验证14 / 20
Key Finding

Best Performance

42.07%

MAPE · MAS-FL-LLM · 所有方法中最优

相比 FedAvg(MAPE 55.15%)降低 24%,相比集中式 GBR(64.33%)降低 35%。仅需 20 轮通信即达最优。

核心指标15 / 20
Ablation

Ablation Study

消融实验

Ablation Study
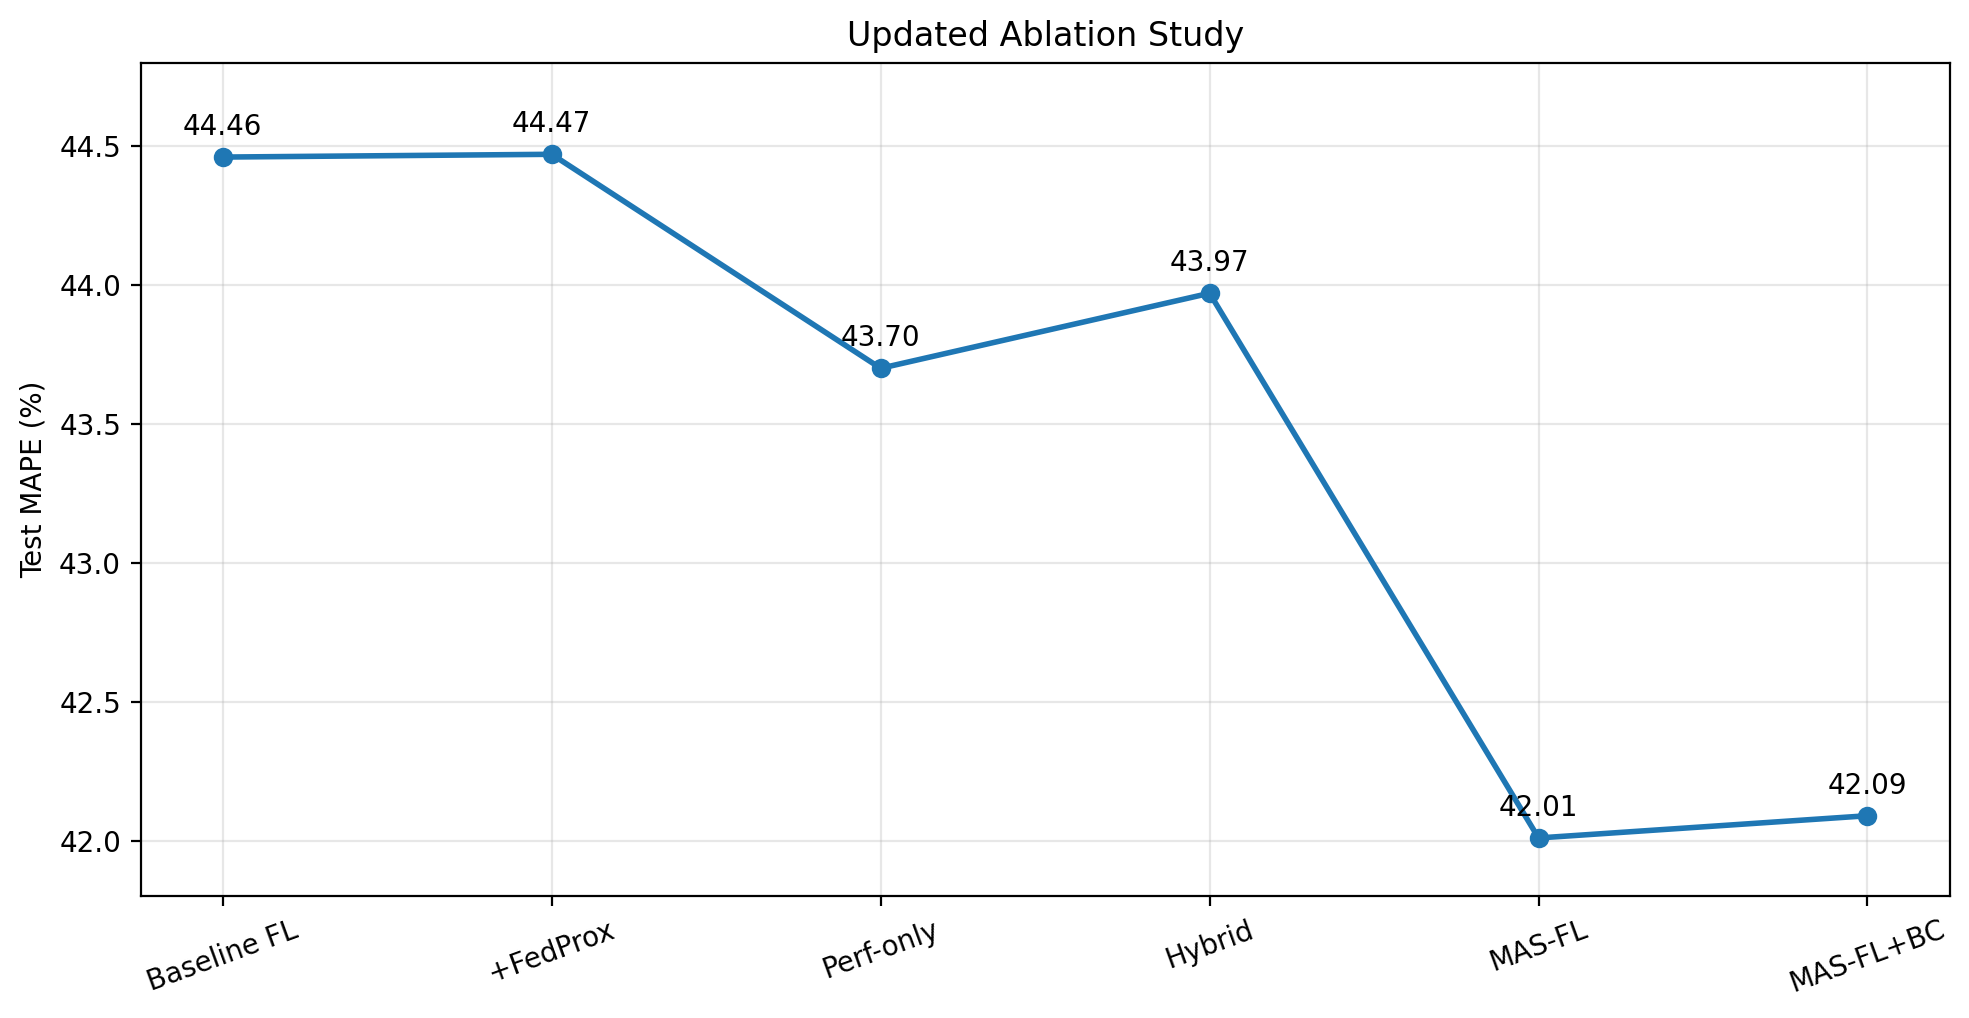
Fig. Ablation study results
LLM Strategy Timeline
Fig. LLM strategy selection over 20 rounds

移除 LLM 动态决策(固定 hybrid):MAPE 上升至 55.26%。LLM 在第 5 轮后根据训练状态自适应切换策略是性能提升的关键。

消融实验16 / 20
Robustness

Multi-Seed & Stratified Evaluation

鲁棒性分析
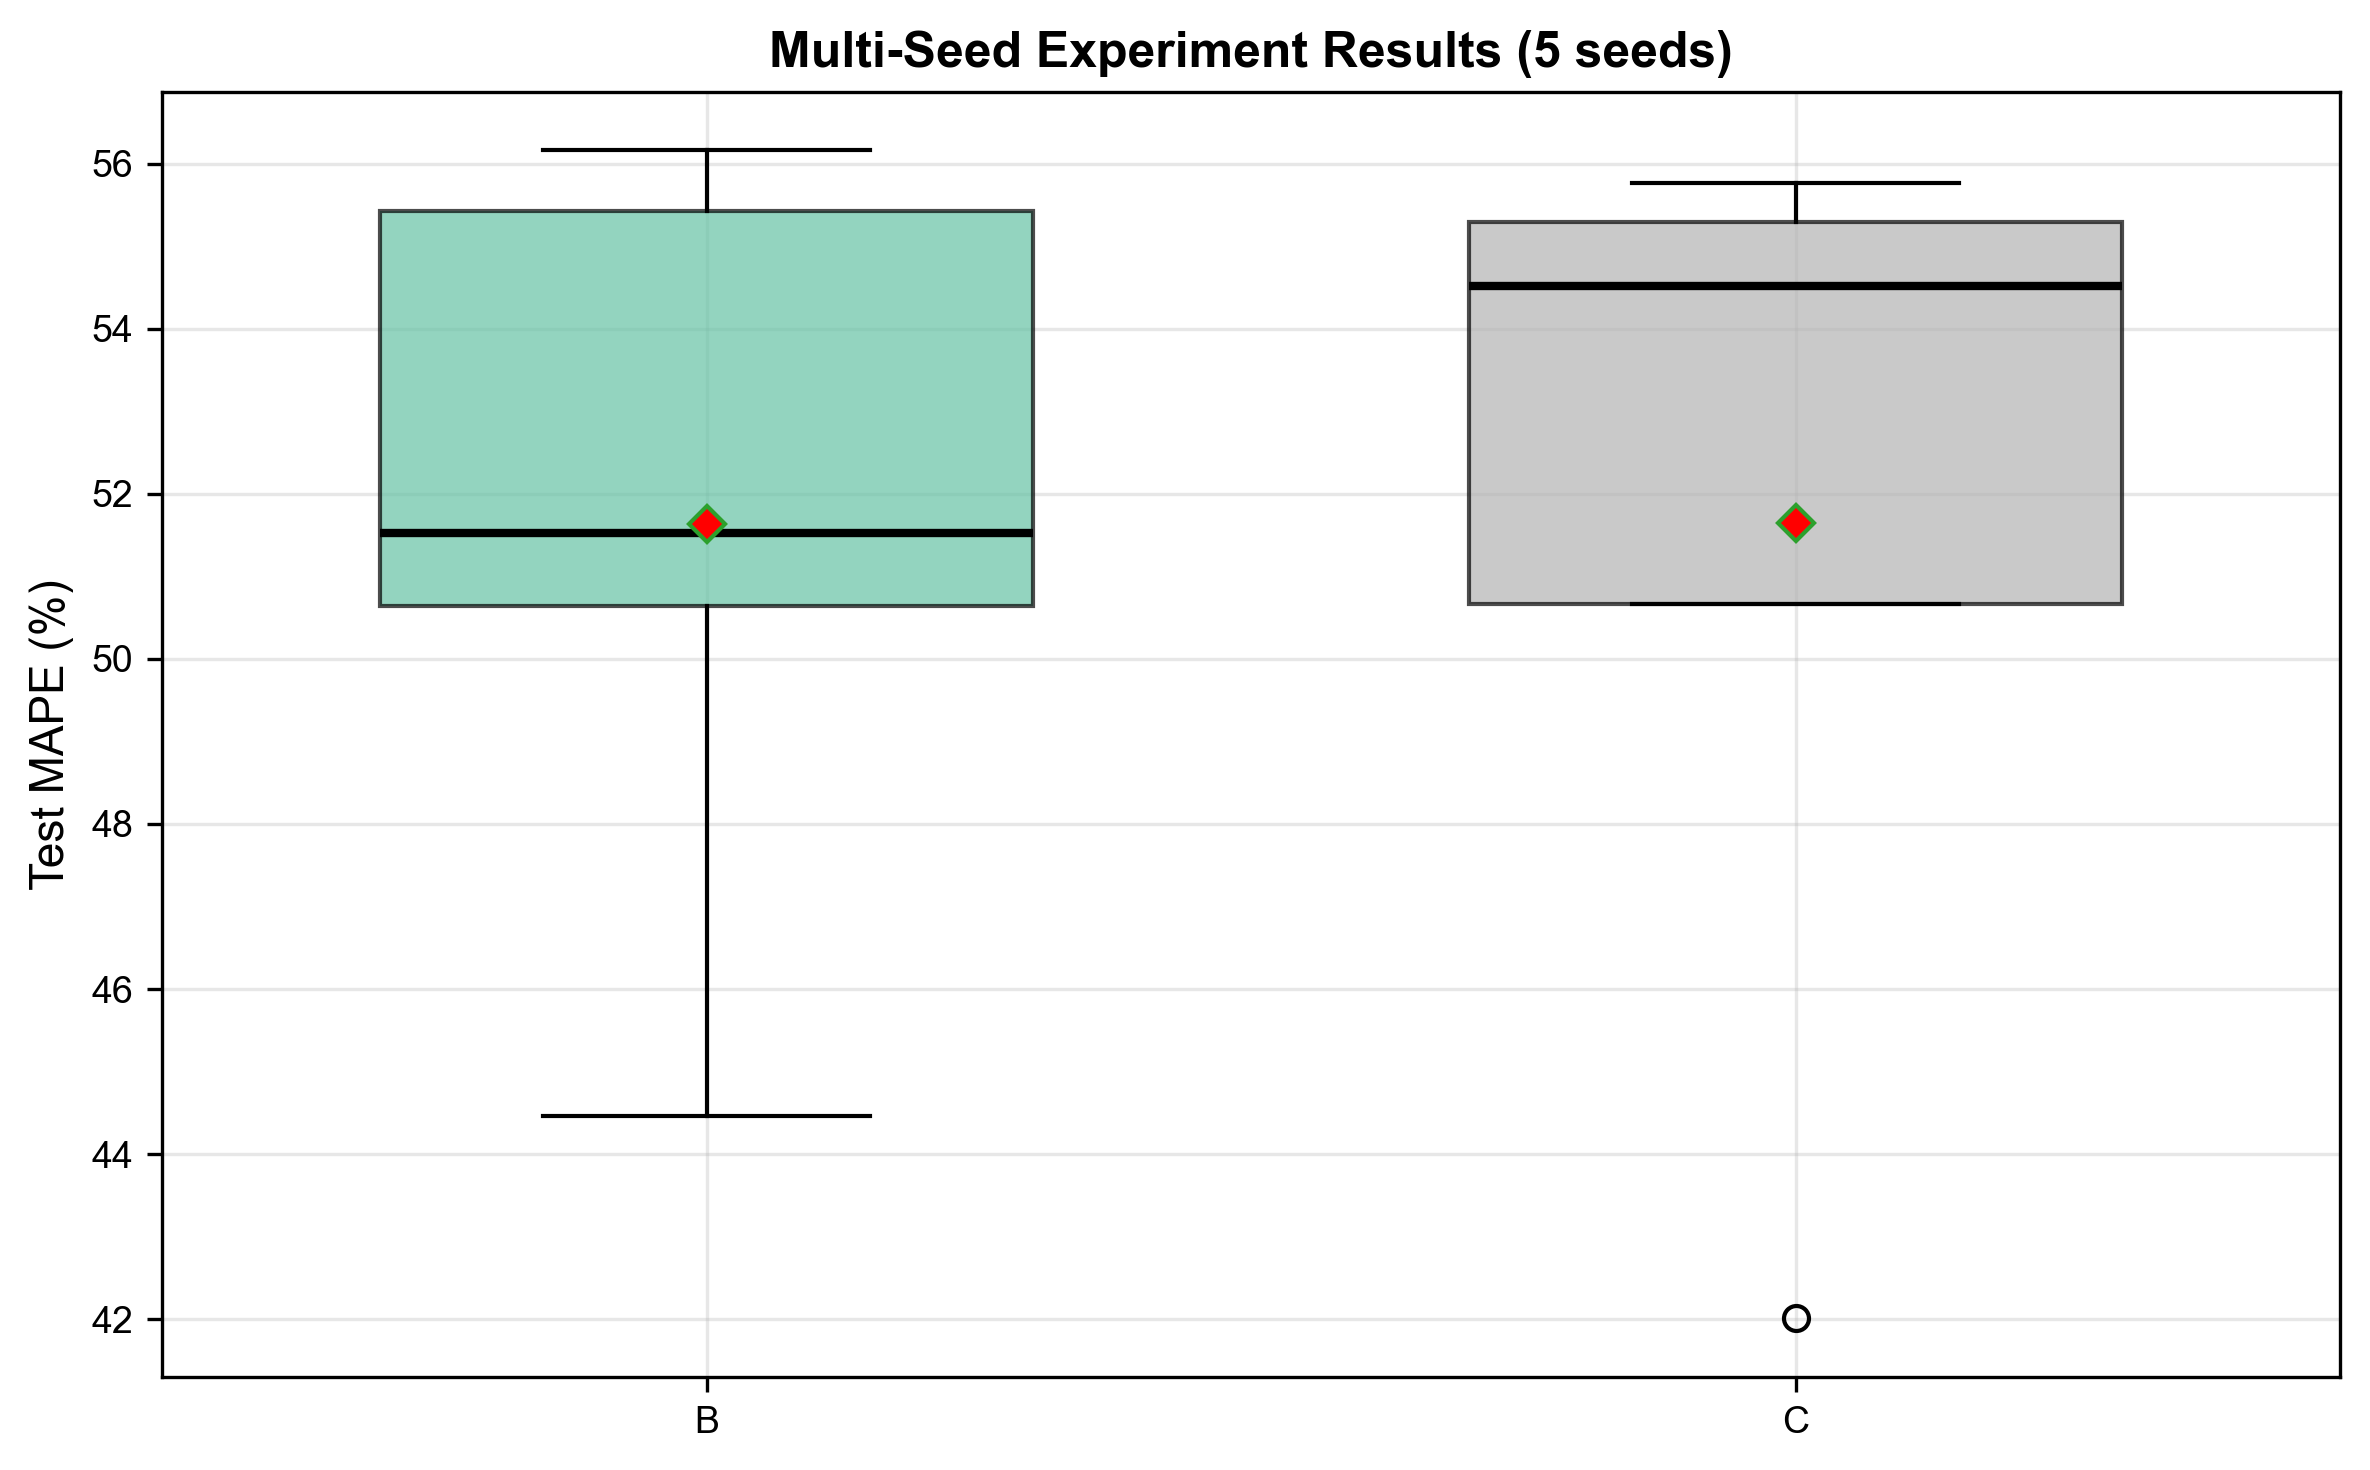
Multi-Seed Boxplot
Fig. 5 seeds (42/123/456/789/2024) distribution
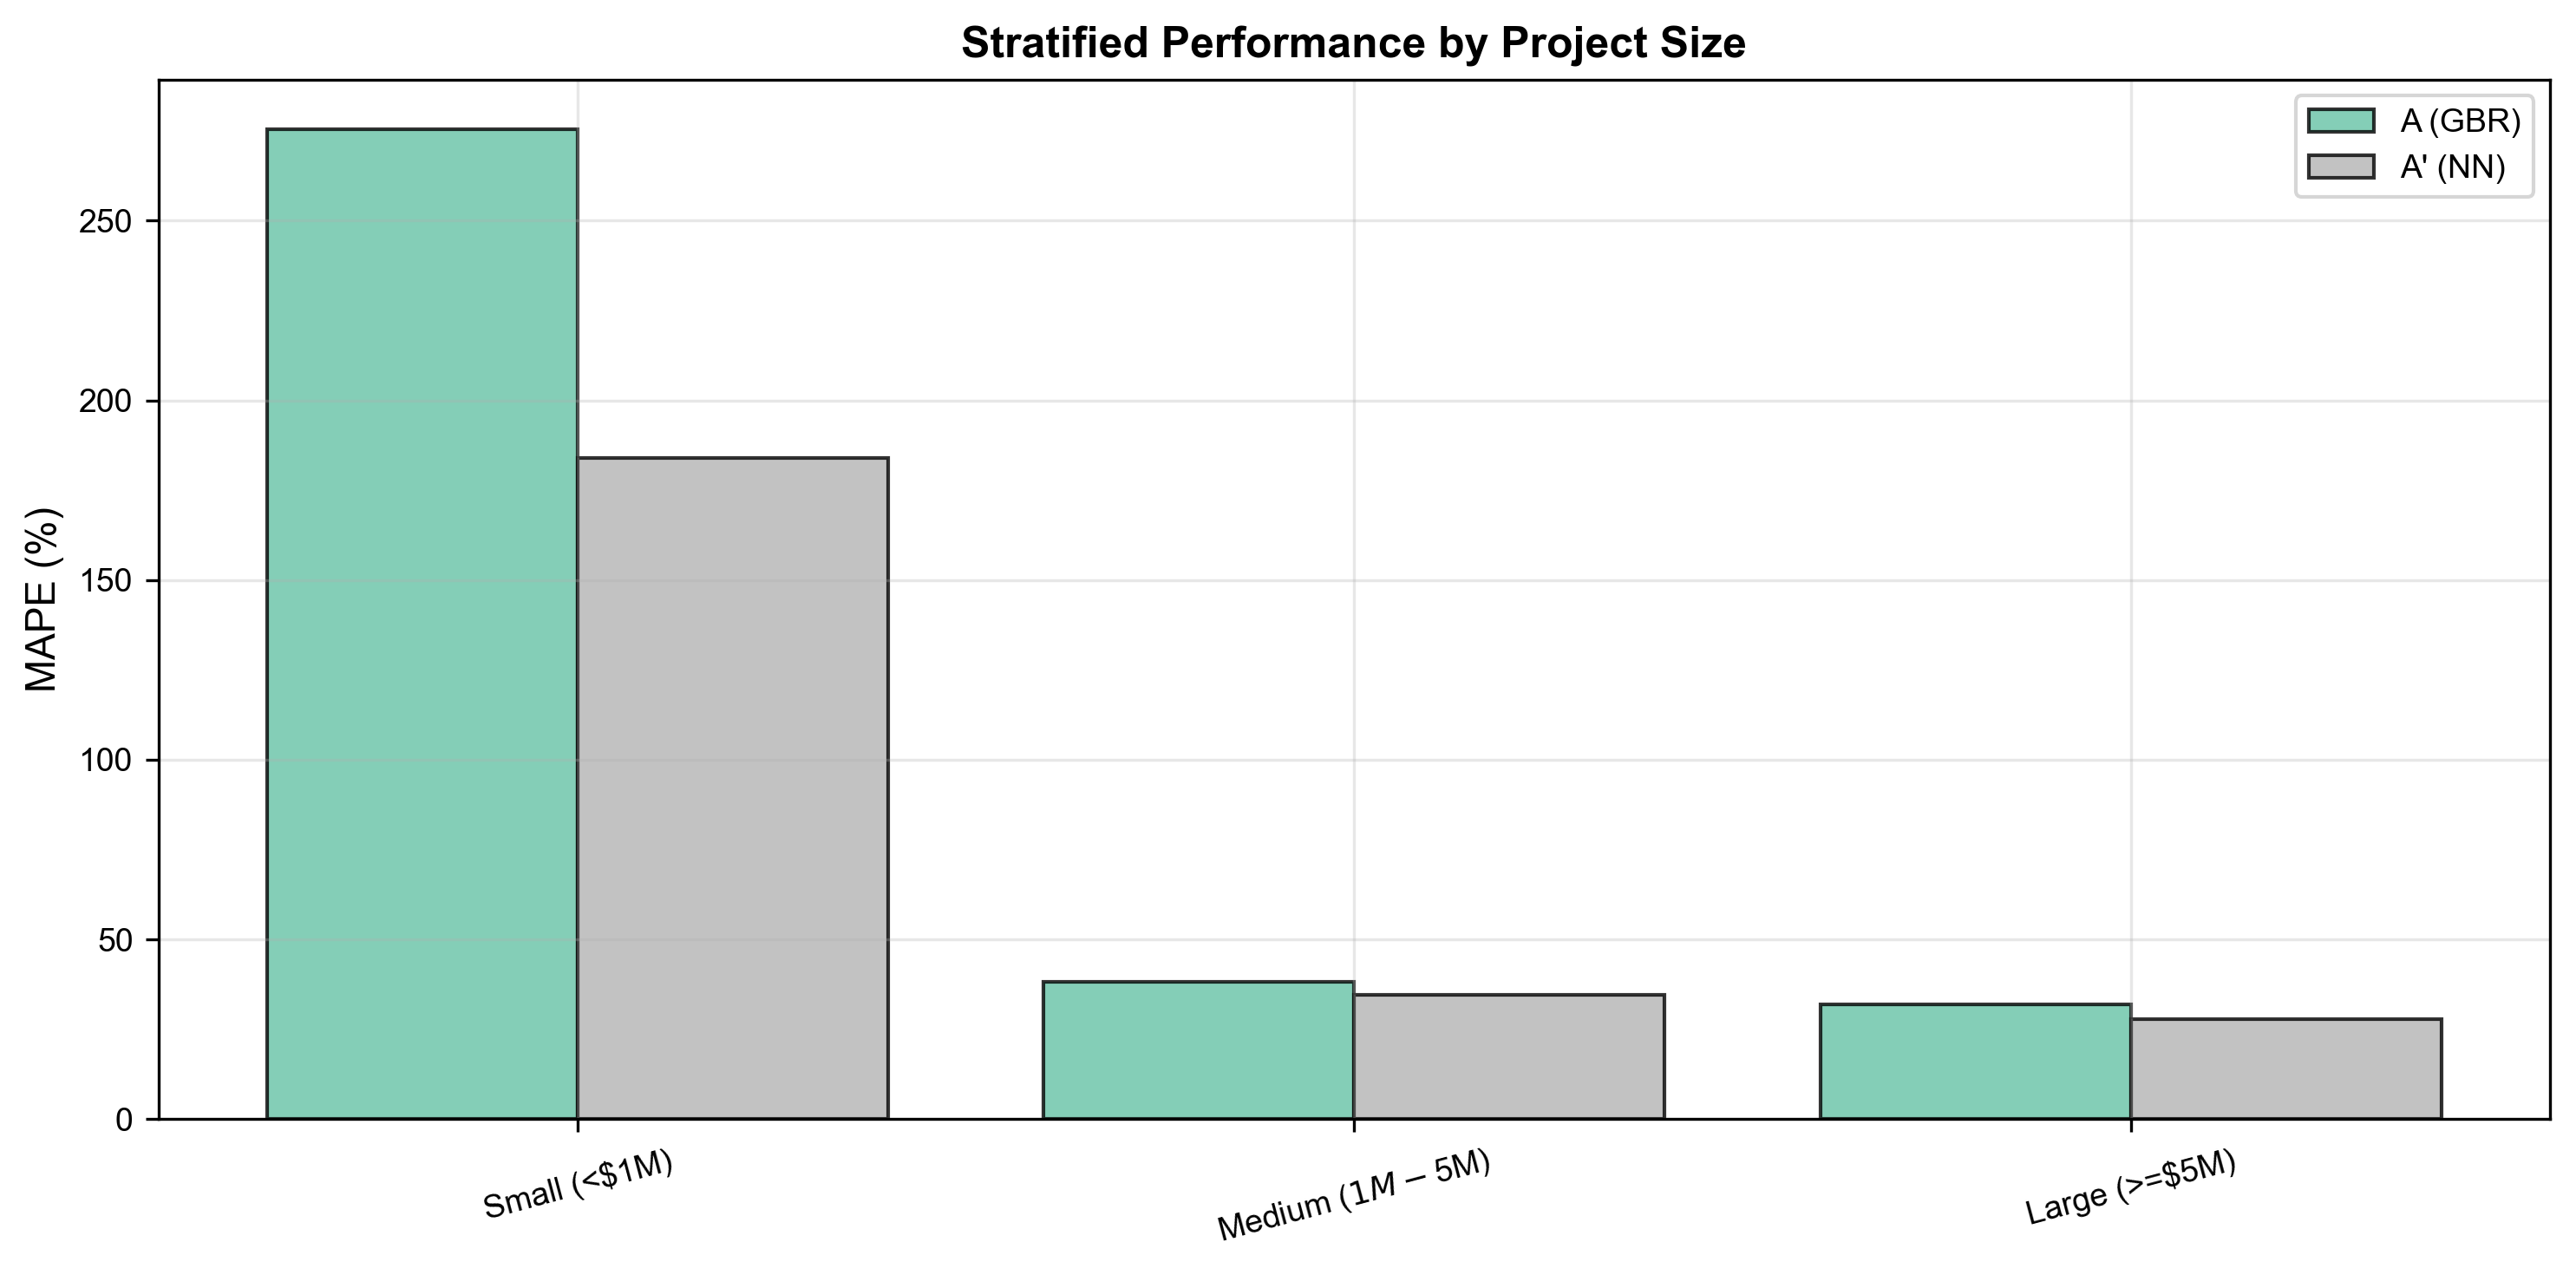
Stratified Evaluation
Fig. Performance by project size (S/M/L)

5 组随机种子验证统计显著性;按项目规模分层评估(小型 <$1M / 中型 $1M-$5M / 大型 ≥$5M),各层级均优于基线。

鲁棒性17 / 20
Bias

Bias Correction

偏差修正

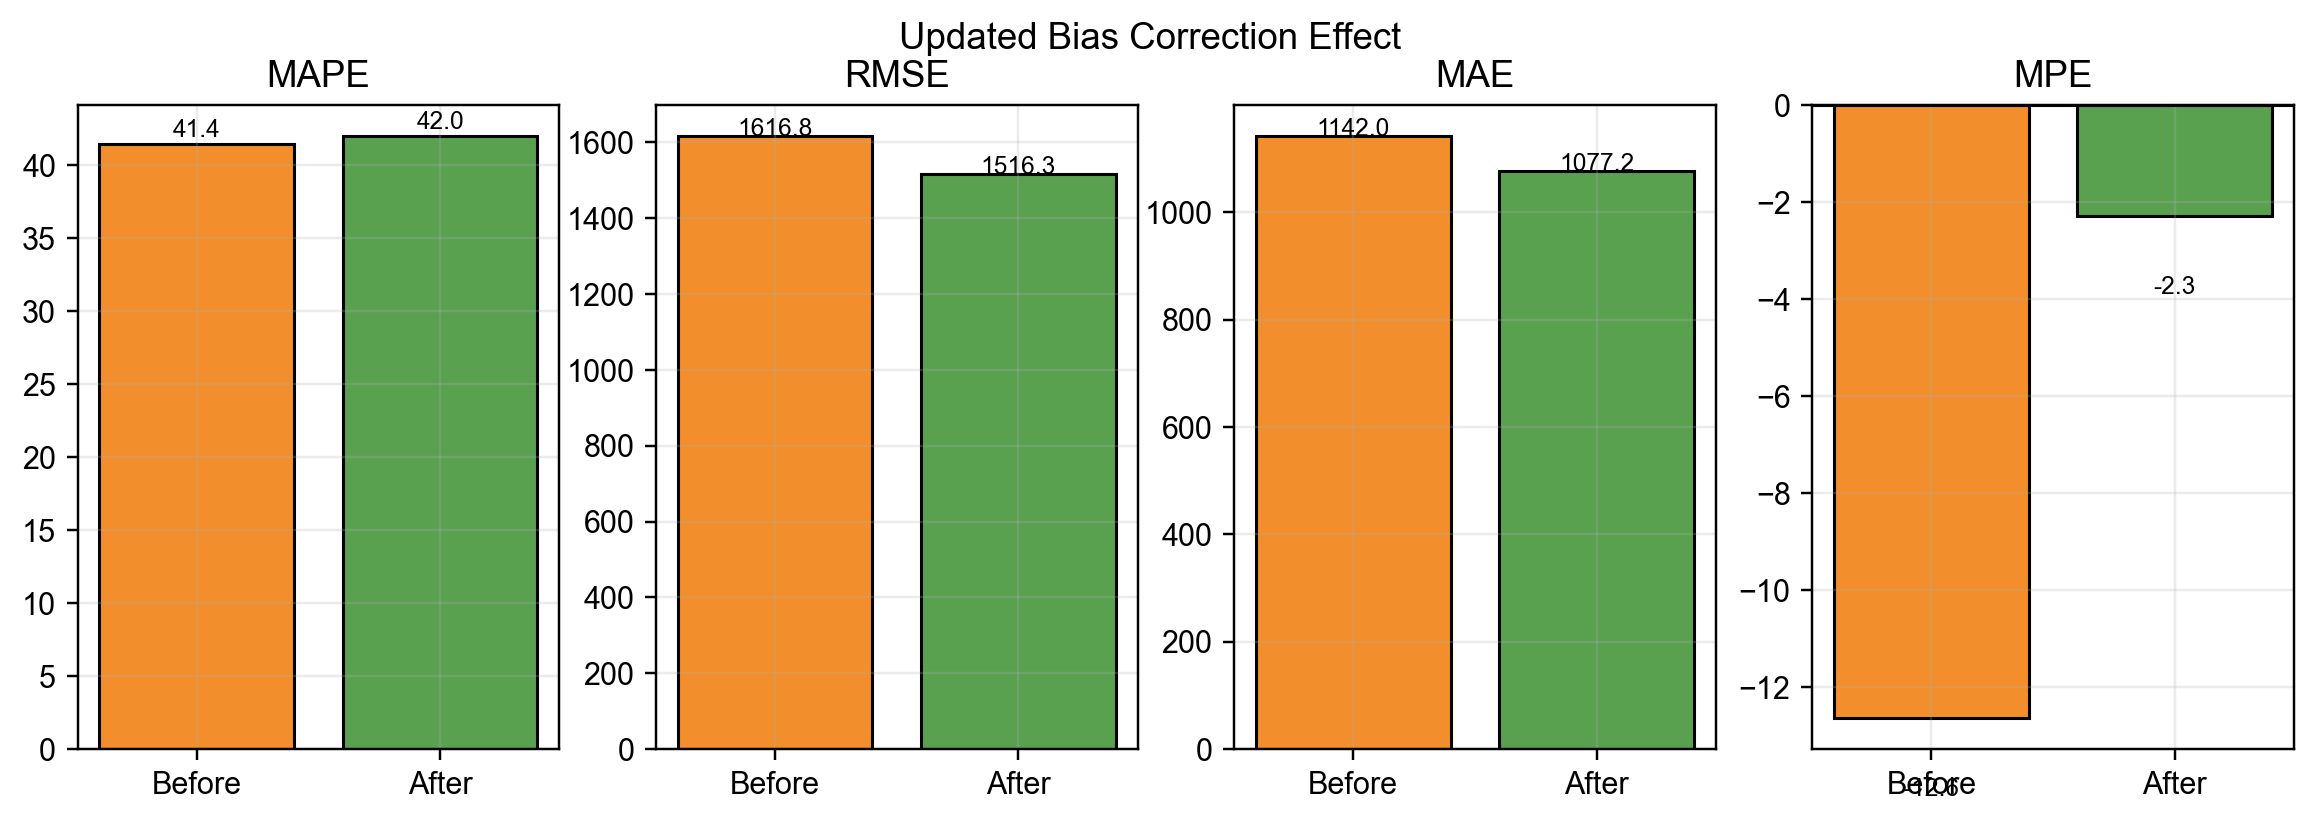
Bias Correction
Fig. MPE bias correction results
Before (MPE)-15.8%系统性低估偏差
After (MPE)-1.3%偏差修正 91.7%,R² 提升至 0.437
偏差修正18 / 20
Contributions

Key Contributions

核心贡献

隐私保护联邦框架 水平 FL + FedProx 正则化,数据不出本地,满足各州 DOT 隐私法规。
LLM 动态策略选择 DeepSeek 从 4 种聚合策略中实时选择最优方案,MAPE 降低 24%(vs FedAvg)。
MPE 偏差修正 基于 MPE 的后处理修正,系统偏差从 -15.8% 降至 -1.3%,R² 提升 37%。

首次将 LLM 驱动的多智能体系统引入联邦学习聚合决策,实现了从"固定规则聚合"到"上下文感知的自适应聚合"的范式转变。

MAS-FL-LLM · First in Highway Cost Estimation
核心贡献19 / 20
Closing

Thank You

恳请各位老师批评指正

Agent-Augmented Federated Learning
for Highway Cost Estimating

MAS-FL-LLMQ&A
MAS-FL-LLM Framework20 / 20
← 返回个人主页